CASE 01 ・ 碩士論文
碩士論文|
比較人類、AI 協作與生成式 AI 的創造力
探索 AI 協作與人類創造力差異|基於抽象與具象尺度問題的創造力評估。從定義問題、設計實驗、自建工具到分析結論的完整研究過程。
完成三組創造力對照實驗,並提出一套「AI 發散、人收斂」的創意流程
量化以語意距離與專家評分量化創造力,13,549 筆有效回答計算語意距離,抽樣 1,800 筆由 6 位專家評分
做法用語意距離當客觀指標,自建限時問卷與評分網站,用分層抽樣控制評分量
TIMELINE時間軸
階段 1
定義問題與指標
確定要比較的三種創意模式,並決定用語意距離、專家評分、流暢性三個指標衡量創造力。
階段 2
設計實驗與選題
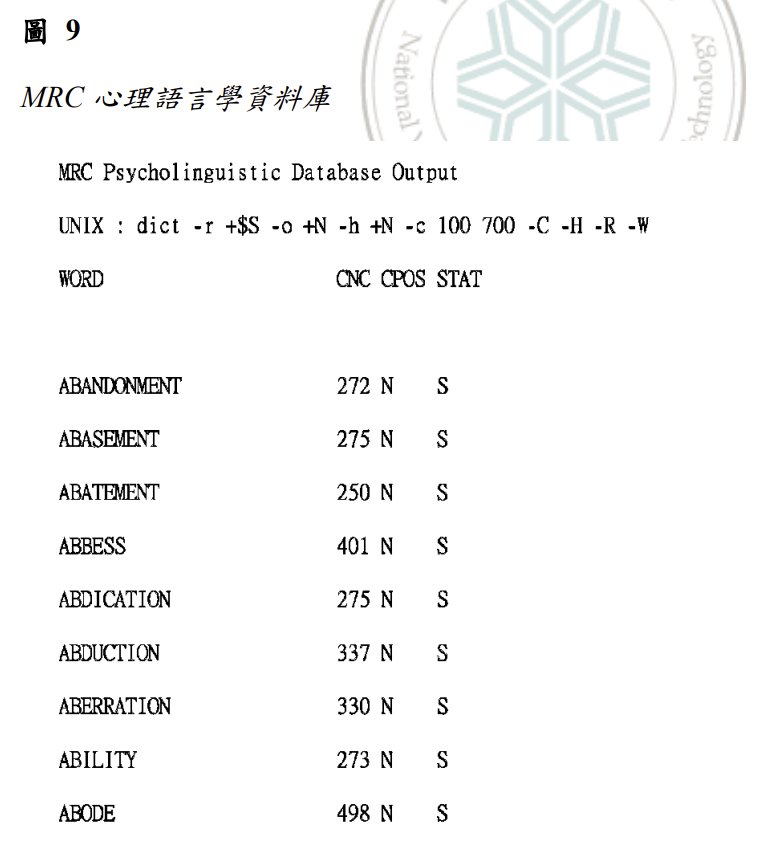
從 MRC 資料庫挑出 10 個抽象到具象的刺激詞,規劃三組的作答流程與每題 4 分鐘限時。
階段 3
自建問卷並施測
用 LimeSurvey 客製倒數計時與自動跳題,完成 42 名受試者與 21 次 AI 對話的施測。
階段 4
抽樣與專家評分
13,549 筆回答分層抽樣成 1,800 筆,透過自建評分網站交給 6 位專家評分。
2025.06
分析與結論
用 R 與 SPSS 分析資料,整理出創意思考流程,完成論文。
PROBLEMS遇到的問題與解法
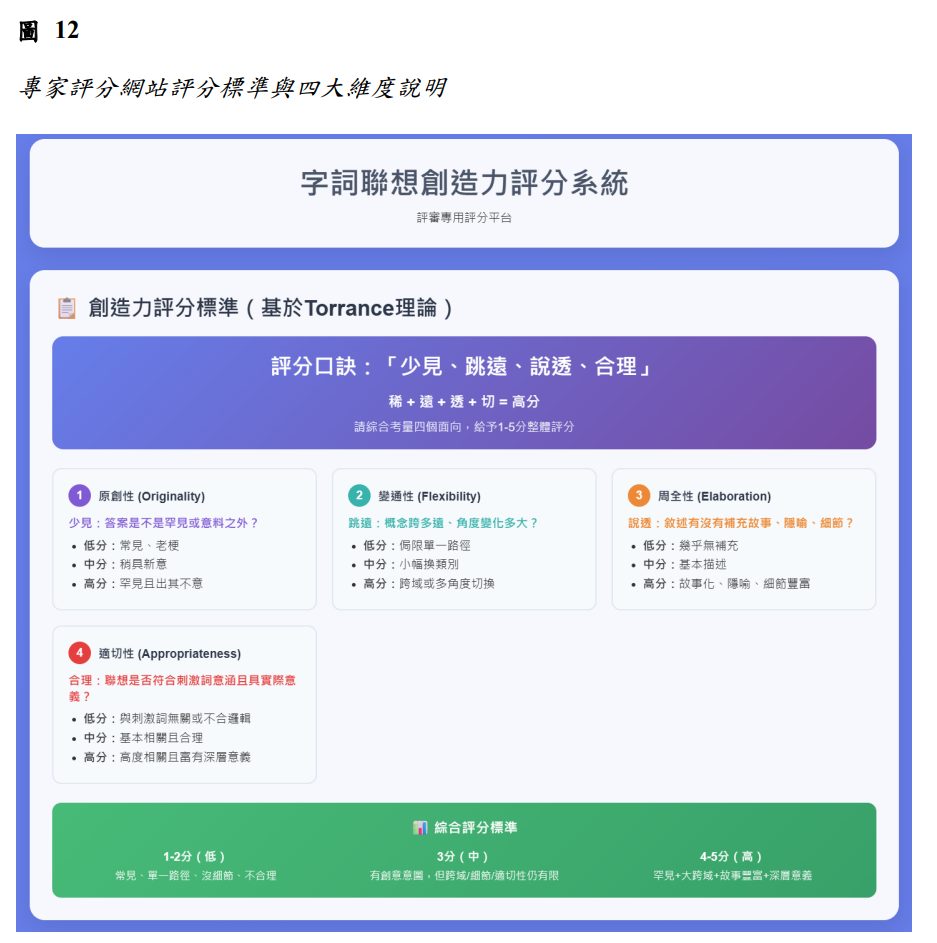
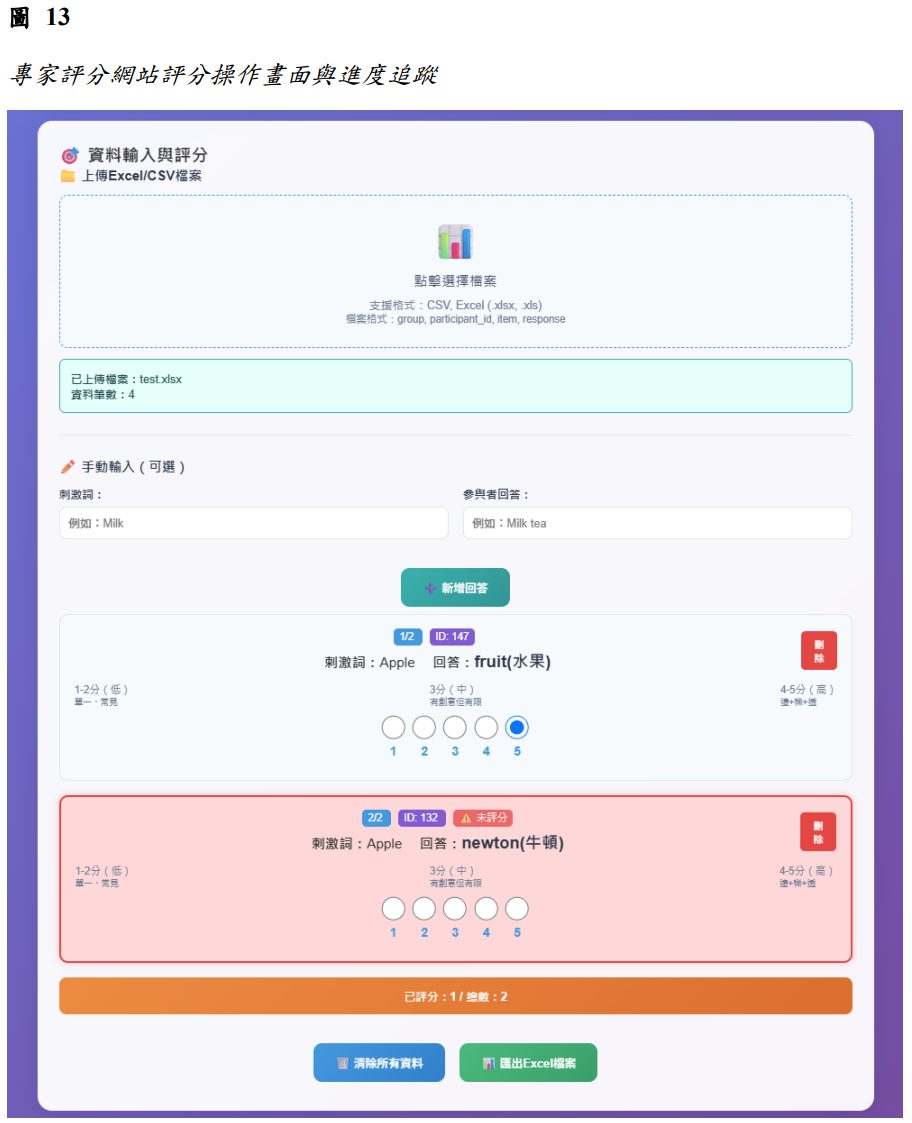
關鍵決策回答太多,專家評不完|縮小評分範圍
問題收到 13,549 筆有效回答,6 位專家不可能全部評完。
決策用雙層分層抽樣(先依組別、再依題目)抽出 1,800 筆,讓每組、每題都有代表;再自建評分網站,統一評分標準、顯示進度、一鍵匯出。
取捨放棄「每一筆都由專家評分」,換取專家能在合理時間內用同一套標準完成;語意距離仍以全部 13,549 筆計算。
結果評分量降到原本約 13%,6 位專家完成評分。
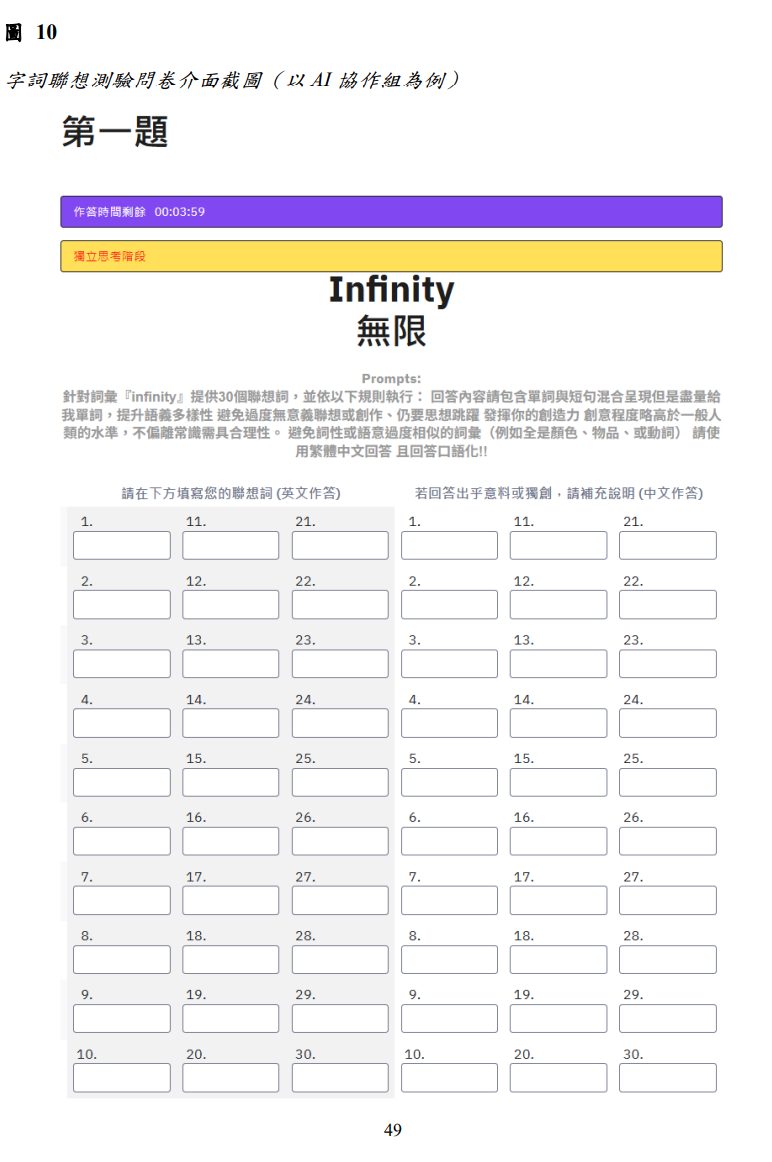
Google 表單做不到實驗規格
問題每題要限時 4 分鐘、時間到自動跳題,AI 協作組還要分階段提示,一般表單做不到,也做不到逐一輸入字詞的作答格式。
解法改用 LimeSurvey,用程式碼客製倒數計時、自動跳題與階段提示。
結果三組在相同條件下作答,資料可以直接生成 Excel,方便整理與分析。
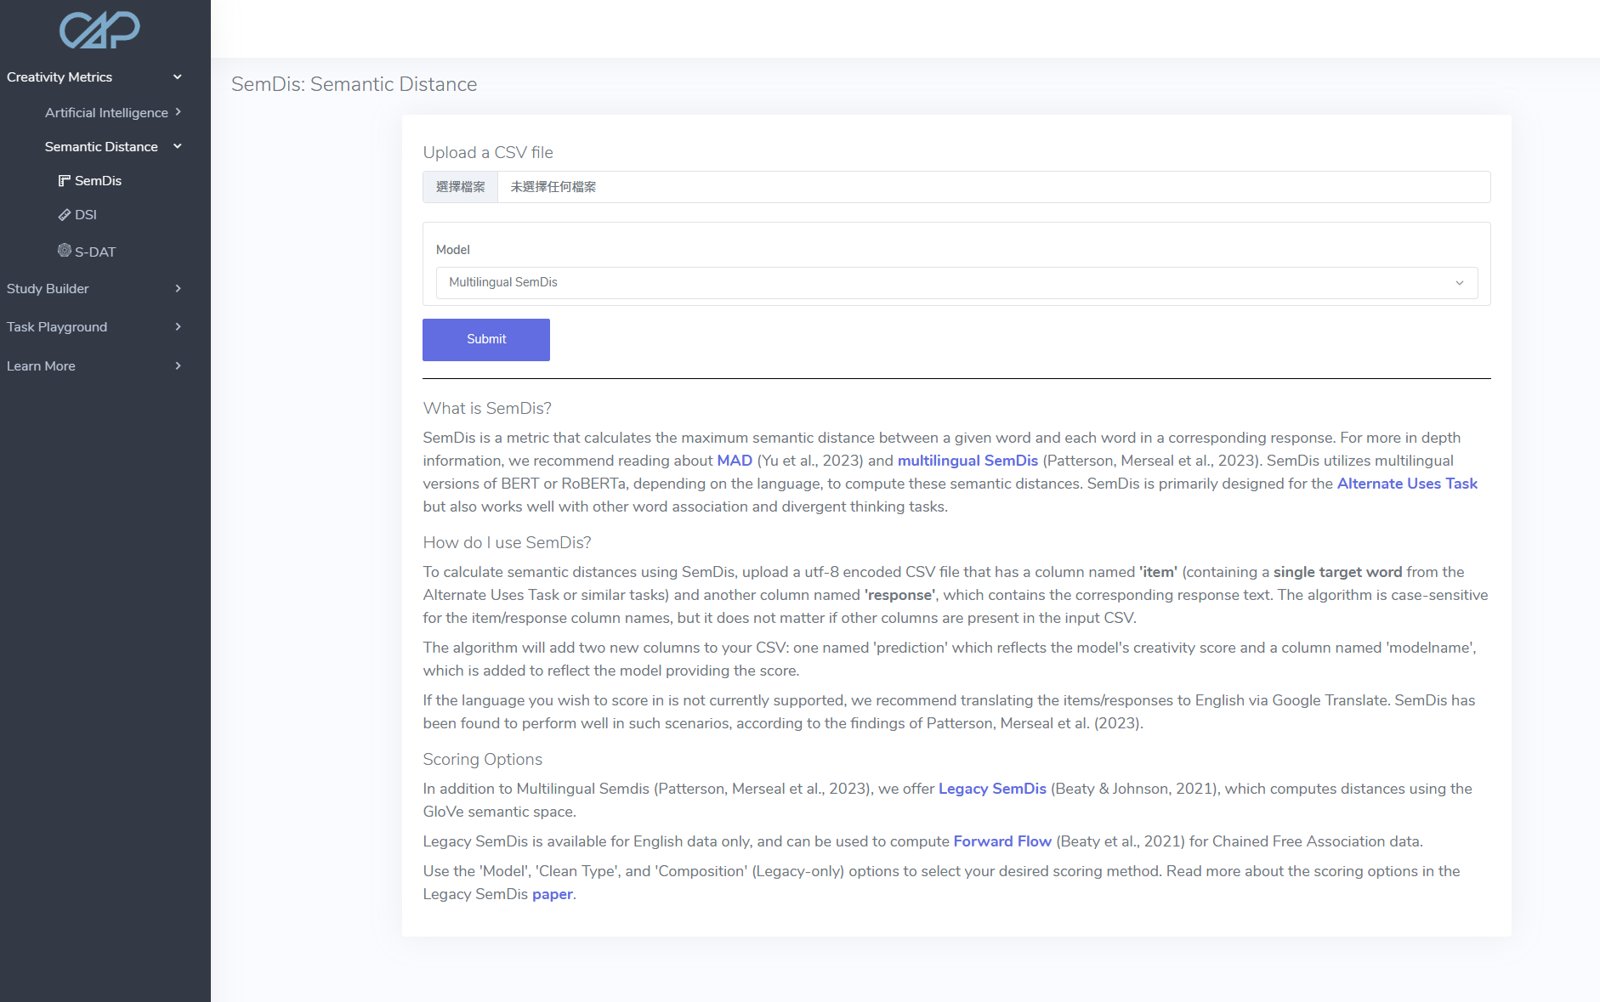
創造力很難客觀測量
問題傳統多靠人主觀評分,三組之間很難公平比較。
解法用 SemDis 計算語意距離(聯想詞跟題目的意義相距多遠),再搭配專家評分與流暢性,三個角度一起看。
結果每一筆回答都有可以量化比較的分數。
題目的抽象程度要能控制
問題要比較不同抽象程度的題目,挑選題目需要一個客觀的依據。
解法使用 MRC 心理語言學資料庫的具象度量表,依分數切成十段,從抽象到具象各挑一個代表詞(As、Infinity … Apple、Milk),用客觀的方式選題。
結果抽象程度變成可以分析的變數。
DESIGN實驗設計
人類組21 人,獨立作答
AI 協作組21 人,1 分鐘獨立思考+3 分鐘與 AI 協作
生成式 AI 組21 次獨立對話,每次重開視窗
三組都作答同樣的 10 個刺激詞、每題 4 分鐘,資料以 R 與 SPSS 進行統計分析。
RESULT結果
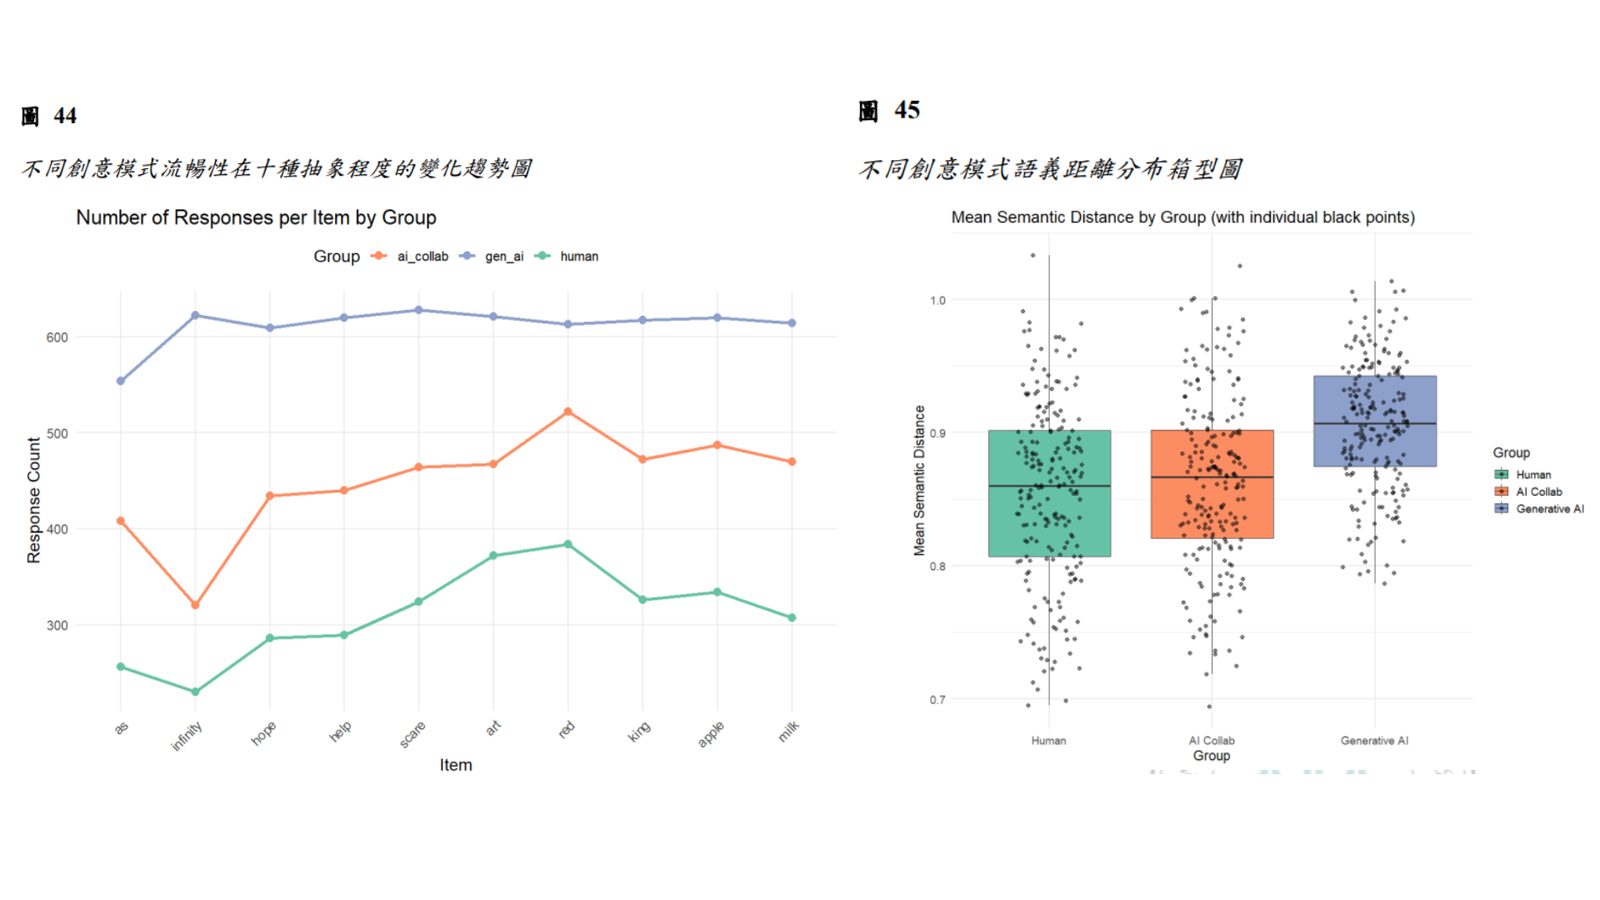
生成式 AI 的流暢度與語意距離較高;人類的想法變異性較大,少數受試者在某些題目上甚至超過兩種 AI 模式;三種模式的專家評分沒有顯著差異。
依據這個結果,我制定出一套創意思考流程。
STEP 1生成式 AI 負責抽象發散
→
STEP 2人類負責價值評鑑
→
STEP 3AI 協作精煉
這個專案讓我體會到,先決定好方法、把流程規劃清楚,專案才可以順利推進。遇到工具做不到的地方,就自己做一個。